Transformer 学习笔记(二):核心组件
2025-12-20 · Qi Lu · Views:
Transformer 的强大能力建立在三个精心设计的核心组件之上:分词器(Tokenizer)将文本转换为模型可处理的离散符号;位置编码(Position Encoding)为自注意力机制注入序列顺序信息;门控机制(Gating)让网络学会选择性地传递信息。
本文深入探讨这三个组件的设计原理与工程实现。
1. 分词器(Tokenizer)
分词器是大语言模型的入口,负责将原始文本转换为 token 序列:
\[\text{"Hello world"} \xrightarrow{\text{Tokenizer}} [15496, 995] \xrightarrow{\text{Embedding}} \mathbb{R}^{2 \times d}\]1.1 分词粒度的权衡
| 粒度 | 词表大小 | 序列长度 | 问题 |
|---|---|---|---|
| 字符级 | ~256 | 很长 | 序列过长,难以建模长距离依赖 |
| 词级 | ~100K+ | 短 | OOV 问题,词表过大 |
| 子词级 | ~32K-128K | 适中 | 平衡,主流选择 |
1.2 Byte Pair Encoding (BPE)
BPE 是最广泛使用的子词分词算法,源自数据压缩领域。
训练算法:
- 初始化词表为所有字符(或字节)
- 统计相邻 token 对的频率
- 将最高频的 token 对合并为新 token,加入词表
- 重复步骤 2-3,直到达到目标词表大小
示例:假设语料为 “low lower lowest”
- 初始:
l, o, w, e, r, s, t, _(_ 表示词边界)- 最高频对
(l, o)→ 合并为lo- 最高频对
(lo, w)→ 合并为low- 最高频对
(low, e)→ 合并为lowe- …
分词算法:
def bpe_tokenize(text, merges):
    tokens = list(text)  # 初始为字符
    for (a, b) in merges:  # 按训练顺序
        i = 0
        while i < len(tokens) - 1:
            if tokens[i] == a and tokens[i+1] == b:
                tokens = tokens[:i] + [a+b] + tokens[i+2:]
            else:
                i += 1
    return tokens
1.3 Byte-level BPE
GPT-2 引入的改进,直接在字节级别操作:
- 基础词表为 256 个字节,无需预分词
- 可以表示任何 UTF-8 文本,无 OOV 问题
- 避免了不同语言的特殊处理
1.4 WordPiece vs BPE
WordPiece 由 Google 提出,用于 BERT。与 BPE 的主要区别在于合并策略:
- BPE:选择频率最高的 token 对
- WordPiece:选择使语言模型似然提升最大的 token 对
WordPiece 使用 ## 标记非词首子词:
"tokenization" -> ["token", "##ization"]
1.5 Unigram Language Model
Unigram 采用相反的策略——从大词表开始,逐步删减:
- 初始化一个较大的候选词表
- 用 EM 算法估计每个 token 的概率
- 计算移除每个 token 对似然的影响
- 移除影响最小的 token
- 重复直到达到目标词表大小
优势:同一文本可能有多种分词方式,支持采样(Subword Regularization)。
1.6 SentencePiece 与 Tiktoken
SentencePiece(Google):
- 语言无关:将空格视为普通字符(用 ▁ 表示)
- 支持 BPE 和 Unigram
- 可逆:分词结果可以无损还原原文
import sentencepiece as spm

# 训练
spm.SentencePieceTrainer.train(
    input='corpus.txt',
    model_prefix='tokenizer',
    vocab_size=32000,
    model_type='bpe',
)

# 使用
sp = spm.SentencePieceProcessor(model_file='tokenizer.model')
tokens = sp.encode('Hello world', out_type=str)
# ['▁Hello', '▁world']
Tiktoken(OpenAI):
- Rust 实现:比 Python 实现快 3-6 倍
- 正则预分词:用正则表达式预先切分
- GPT-4 使用 cl100k_base 编码
import tiktoken

enc = tiktoken.get_encoding("cl100k_base")
tokens = enc.encode("Hello world")  # [9906, 1917]
print(enc.n_vocab)  # 100277
1.7 主流模型的词表配置
| 模型 | 词表大小 | 分词器 |
|---|---|---|
| GPT-2 | 50,257 | Byte-level BPE |
| GPT-4 | 100,277 | Byte-level BPE (cl100k) |
| BERT | 30,522 | WordPiece |
| LLaMA | 32,000 | SentencePiece BPE |
| LLaMA 3 | 128,256 | Tiktoken BPE |
| Qwen | 151,936 | Byte-level BPE |
| DeepSeek | 102,400 | Byte-level BPE |
词表大小的影响:
- 更大词表:更短的序列长度,更大的 Embedding 参数,更好的多语言支持
- 更小词表:更长的序列,更小的模型参数,稀有词可能被过度切分
1.8 多语言分词:公平性问题
不同语言的 token 效率差异显著(GPT-4,相同语义内容):
| 语言 | Token 数 | 相对英语 |
|---|---|---|
| 英语 | 100 | 1.0× |
| 西班牙语 | 120 | 1.2× |
| 中文 | 150 | 1.5× |
| 日语 | 180 | 1.8× |
| 缅甸语 | 400 | 4.0× |
效率差异的根源:
-
字母文字 vs 表意文字:英语 26 个字母组合成词,BPE 容易学到常见子词。中文每个字是独立语素,约需 3500 个常用字覆盖 99.9% 文本。
-
训练数据偏斜:当训练语料中英文占 90% 时,英文子词被充分合并,而中文词汇因频率低而保持拆分。
-
UTF-8 编码开销:英文字符占 1 字节,中文字符占 3 字节。在 Byte-level BPE 中,一个中文字至少需要 3 个基础 token。
实际影响:
- 成本:相同语义内容消耗 1.5-4 倍 token,API 费用相应增加
- 上下文:有效上下文窗口缩短(128K tokens 对中文用户相当于英文用户的 85K)
- 延迟:生成相同内容需要更多解码步骤
改进策略:
- LLaMA 3 将词表从 32K 扩展到 128K,中文 token 效率提升约 3 倍
- 在分词器训练时对低资源语言进行上采样
2. 位置编码
自注意力机制本身是置换不变的(permutation invariant)——纯粹的 Attention 模块无法捕捉输入顺序。位置编码的引入是必不可少的。
2.1 位置编码分类
| 类型 | 方法 | 作用位置 | 外推性 | 代表模型 |
|---|---|---|---|---|
| 绝对 | Sinusoidal | Embedding | 差 | Transformer |
| 绝对 | Learned | Embedding | 差 | BERT, GPT |
| 相对 | T5 Bias | Attention score | 好 | T5 |
| 相对 | ALiBi | Attention score | 好 | BLOOM, MPT |
| 相对 | RoPE | Q/K 向量 | 好 | LLaMA, Qwen |
2.2 绝对位置编码
训练式(Learned): 最朴素的方案,将位置编码作为可训练参数。例如最大长度 512、编码维度 768,则初始化一个 $512 \times 768$ 的矩阵。
缺点:缺乏外推性——预训练最大长度为 512,则无法处理更长的序列。
三角函数式(Sinusoidal):
\[p_{k,2i} = \sin\left(k / 10000^{2i/d}\right), \quad p_{k,2i+1} = \cos\left(k / 10000^{2i/d}\right)\]设计直觉:不同维度对应不同频率的周期函数——低维变化快(捕捉局部位置),高维变化慢(捕捉全局位置)。
2.3 旋转位置编码(RoPE)
RoPE 是目前最主流的位置编码方法,被 LLaMA、Mistral、Qwen 等模型广泛采用。
核心思想:融合绝对位置与相对位置——通过在 Q、K 上施加绝对位置的旋转操作,使得内积自然地只依赖于相对位置。
理论起源:RoPE 的设计灵感来自复数的性质:
\[\langle q e^{im\theta}, k e^{in\theta} \rangle = \text{Re}[q \bar{k} e^{i(m-n)\theta}]\]只依赖相对位置 $m-n$。
问题设定:给 $\mathbf{q}, \mathbf{k}$ 添加绝对位置信息:
\[\tilde{\mathbf{q}}_m = f(\mathbf{q}, m), \quad \tilde{\mathbf{k}}_n = f(\mathbf{k}, n)\]希望内积结果带有相对位置信息:
\[\langle f(\mathbf{q}, m), f(\mathbf{k}, n) \rangle = g(\mathbf{q}, \mathbf{k}, m-n)\]二维情况的解:
\[\boxed{f(\mathbf{q}, m) = \|\mathbf{q}\| e^{i(\Theta(\mathbf{q}) + m\theta)} = \mathbf{q} e^{im\theta}}\]这正是向量乘以旋转因子 $e^{im\theta}$,对应旋转角度 $m\theta$。
矩阵形式:
\[\text{RoPE}(\mathbf{x}, m) = \begin{pmatrix} \cos m\theta_1 & -\sin m\theta_1 & & \\ \sin m\theta_1 & \cos m\theta_1 & & \\ & & \cos m\theta_2 & -\sin m\theta_2 \\ & & \sin m\theta_2 & \cos m\theta_2 \\ & & & & \ddots \end{pmatrix} \mathbf{x}\]频率参数:
\[\theta_i = \text{base}^{-2(i-1)/d}, \quad i = 1, 2, \ldots, d/2\]其中 $\text{base} = 10000$ 是原始设置。
关键性质:
\[(\mathbf{R}_m \mathbf{q})^\top (\mathbf{R}_n \mathbf{k}) = \mathbf{q}^\top \mathbf{R}_m^\top \mathbf{R}_n \mathbf{k} = \mathbf{q}^\top \mathbf{R}_{n-m} \mathbf{k}\]内积自动包含相对位置信息。$\mathbf{R}_m$ 是正交矩阵,不改变向量模长,保持模型稳定性。
高效实现:
\[\text{RoPE}(\mathbf{x}, m) = \mathbf{x} \odot \cos(m\boldsymbol{\theta}) + \text{rotate\_half}(\mathbf{x}) \odot \sin(m\boldsymbol{\theta})\]复杂度为 $O(d)$,无需构建完整的旋转矩阵。
2.4 RoPE 的 Base 选择
语义区分度定义为模型区分相似 token 和随机 token 的能力:
\[B_{m,\theta} = \sum_{i=1}^{d/2} \cos(m\theta_i)\]随着相对距离 $m$ 增大,$B_{m,\theta}$ 逐渐减小(注意力衰减)。当 base 过小时会变为负值——模型反而给随机 token 更高的注意力。
Base 下界与上下文长度的关系:
| Context Length $L$ | 4K | 8K | 32K | 128K | 1M |
|---|---|---|---|---|---|
| Base 下界 $b^*$ | $4.5 \times 10^4$ | $8.4 \times 10^4$ | $6.4 \times 10^5$ | $3.4 \times 10^6$ | $6.5 \times 10^7$ |
渐近分析表明 $b^* \approx O(L)$,即 base 应随上下文长度线性增长。
实际模型的 Base 选择:
- LLaMA 3:训练长度 8192,但 base 选择了 500000,远超下界
- Mixtral:base = 1000000,支持 128K 上下文
2.5 长度外推方法
Position Interpolation (PI):缩放位置索引
\[m' = \frac{m}{s}, \quad s = \frac{L'}{L}\]将长序列”压缩”到原始位置范围内。问题:均匀缩放会破坏高频信息。
NTK-aware Interpolation:调整 base 而非均匀缩放
\[\text{base}' = \text{base} \cdot s^{d/(d-2)}\]将插值压力分散到不同维度:高频维度少插值,低频维度多插值。
YaRN:结合 NTK-by-parts 和注意力温度缩放
\[\text{Attention}'_{ij} = \frac{\mathbf{q}_i^\top \mathbf{k}_j}{\sqrt{d} \cdot t}\]YaRN 只需约 400 步微调即可将 LLaMA 2 从 4K 扩展到 64K。
| Method | Extrapolation | Finetuning | Notes |
|---|---|---|---|
| PI | 2× | Required | 均匀缩放 |
| NTK-aware | 32× | Optional | 无需微调时效果好 |
| YaRN | 16× | Minimal | 结合温度缩放 |
| Dynamic | 64× | None | 推理时动态调整 |
2.6 RoPE vs ALiBi
ALiBi 直接在 attention score 上添加距离惩罚:
\[\text{Attention}_{ij} = \frac{\mathbf{q}_i^\top \mathbf{k}_j}{\sqrt{d}} - m \cdot |i - j|\]| Feature | RoPE | ALiBi |
|---|---|---|
| 编码位置 | Q/K 向量 | Attention score |
| 参数量 | 0 | 0 |
| 外推能力 | 中等(需扩展方法) | 好 |
| KV Cache 友好 | 是 | 是 |
| 采用模型 | LLaMA, Mistral, Qwen | BLOOM, MPT |
2.7 最新进展
iRoPE (LLaMA 4):混合使用 RoPE 层和无位置编码层,配合推理时注意力温度缩放,实现从 256K 训练长度到 10M 上下文窗口的极端外推。
2D/3D RoPE:将 RoPE 扩展到二维(图像)和三维(视频)位置编码。
3. 门控机制
3.1 为什么需要门控?
标准的线性变换 $y = Wx + b$ 对所有输入一视同仁——无论输入内容如何,权重 $W$ 始终相同。
门控机制引入了数据依赖的动态性:
\[y = g(x) \odot f(x)\]其中 $g(x) \in [0, 1]^d$ 是门控信号。关键洞察:$g$ 本身依赖于输入 $x$,使得变换从静态的 $f$ 变为动态的 $g \odot f$。
信息瓶颈视角:门控实现了自适应压缩——当 $g \to 0$ 时可主动丢弃信息。这种”主动遗忘”能力对于过滤噪声、聚焦关键信息至关重要。
稀疏激活视角:门控天然诱导稀疏性。实验表明,门控网络的激活稀疏度可达 60-80%。
3.2 MLP 层的门控:SwiGLU
如第一篇所述,现代 Transformer 普遍采用 SwiGLU 替代标准 FFN:
标准 FFN: \(\text{FFN}(x) = W_2 \cdot \text{GELU}(W_1 x)\)
SwiGLU FFN: \(\text{SwiGLU}(x) = W_2 \cdot \underbrace{(\text{SiLU}(W_1 x) \odot W_3 x)}_{\text{gating}}\)
这里 $W_3 x$ 作为门控信号,控制 $\text{SiLU}(W_1 x)$ 的信息流通。
3.3 Attention 层的门控:Gated Attention
在 Scaled Dot-Product Attention(SDPA)输出后添加 sigmoid 门控:
标准 SDPA: \(Y = \text{softmax}\left(\frac{QK^\top}{\sqrt{H}}\right)V\)
Gated Attention: \(Y' = Y \odot \sigma(XW_g)\)
为什么在 SDPA 输出后门控最优?
| Configuration | Effectiveness |
|---|---|
| Gate on Values | 有效但非最优 |
| Gate on Keys | 有效但非最优 |
| Gate on SDPA output | 最优位置 |
原因:门控作用于最终输出,可以整体抑制整个 attention head 的贡献,打破 softmax 的强制分配约束。本质上实现了 head 级别的动态剪枝。
3.4 Attention Sink 问题
现象观察:在长序列任务中,大量注意力权重集中在序列开头的少数 token(通常是第一个 token),即使这些 token 语义上并不重要。更重要的是,越深的层,这种现象越明显。
StreamingLLM 的关键发现:当使用滑动窗口注意力时,一旦初始 token 被移出窗口,模型输出会完全崩溃。但只需保留最初的 4 个 token,性能就能大幅恢复。
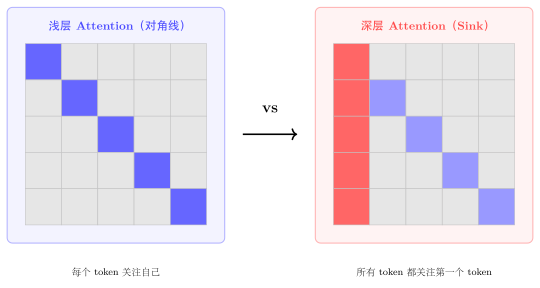
图示说明:左侧浅层注意力主要集中在对角线(每个 token 关注自己);右侧深层注意力的第一列出现 Sink 现象(所有 token 都关注第一个 token)。
表面原因:Softmax 的概率约束
\[\sum_{j=1}^{T} \text{softmax}(q_i^\top k_j / \sqrt{H}) = 1\]每个 query 必须将全部注意力分配出去,即使理想情况下应该”不关注任何 token”。网络的应对策略是学习一个”垃圾桶”位置来吸收多余的注意力。
深层原因:Context-Aware Identity Layer 假设
Attention Sink 源于 Transformer 对”上下文感知的恒等层”的内在需求——模型需要能够根据上下文决定某个 Attention Block 不输出任何变化。
证据:
- Sink Token 的 Value 接近零——模型主动学习将其置零
- Early Decoding 与层深相关——深层需要做的是保持恒等变换
- Sink Token 的 Key 具有独立子空间——模型为其分配了专用空间
3.5 Attention Sink 的解决方案
方案一:保留初始 Token(StreamingLLM)
\[\text{Attention Range} = \{1, 2, \ldots, k_{\text{sink}}\} \cup \{t - w + 1, \ldots, t\}\]保留 4 个初始 token,使模型能稳定处理 400 万+ token 的流式输入。
方案二:可学习的 Softmax Bias
\[\text{Attention}_{ij} = \frac{\exp(q_i^\top k_j / \sqrt{d})}{\sum_k \exp(q_i^\top k_k / \sqrt{d}) + \exp(b_h)}\]其中 $b_h$ 是每个 attention head 的可学习标量。当 $b_h$ 很大时,分母增大,所有注意力权重被”稀释”。
代表模型:GPT-OSS、MiMo-V2-Flash
方案三:Output Gating
\[Y' = Y \odot \text{gate}(X)\]使 attention 可以输出零向量,无需依赖 sink token。
代表模型:Kimi Linear、Qwen
| 方案 | 额外参数 | 消除 Sink | 代表模型 |
|---|---|---|---|
| 保留初始 Token | 0 | 否(绕过) | StreamingLLM |
| Softmax Bias | $n_h$ | 是 | GPT-OSS, MiMo-V2-Flash |
| Output Gating | $D^2$ | 是 | Kimi Linear, Qwen |
理论统一:这些方案都在解决 Attention 如何输出零 的问题。值得注意的是,output gating 不仅消除了 sink,还释放了被 sink 占用的维度——这些容量可以用于更有意义的表示学习。
3.6 门控的工业应用
Gated Attention 已被集成到 Qwen3-Next 架构中,验证了其在大规模工业应用中的有效性。
额外收益:
- 训练稳定性:损失曲线更平滑,可以使用更大的学习率
- 长上下文外推:结合 YaRN,从 32k 训练长度外推到 128k,性能衰减显著小于基线
MLP 门控 vs Attention 门控:两种门控的作用互补:
- MLP 门控(SwiGLU):在特征变换阶段选择性激活神经元
- Attention 门控:在信息聚合阶段选择性传递 attention 输出
现代模型(如 Qwen3-Next)同时采用两者。
本章小结
本章深入探讨了 Transformer 的三个核心组件:
- 分词器:
- BPE 是最主流的子词分词算法
- 多语言效率差异是一个被低估的公平性问题
- LLaMA 3 将词表扩展到 128K 以改善多语言支持
- 位置编码:
- RoPE 通过旋转操作融合绝对与相对位置信息
- Base 应随上下文长度线性增长
- YaRN 等方法可实现有效的长度外推
- 门控机制:
- SwiGLU 在 MLP 层实现选择性激活
- Gated Attention 解决了 Attention Sink 问题
- 门控释放了被 sink 占用的模型容量
下一篇将深入探讨注意力机制的优化:FlashAttention、MLA、稀疏注意力与线性注意力。
Comments